Ihre KI klingt richtig. Aber stimmt es auch?
Ein KI-Assistent kann eine überzeugende Antwort geben und dennoch die wichtigste Tatsache verfehlen. Ein Chatbot kann Hunderte von Gesprächen einwandfrei bewältigen und dann an einer Frage scheitern, die Ihre Nutzer jeden Tag stellen.
LLM-Evaluierung misst, wie gut Ihre KI anhand definierter Kriterien abschneidet, darunter Genauigkeit, Relevanz, Faktentreue und Aufgabenerfüllung. Anders als die breiter angelegten LLM-Testing-Dienstleistungen, die auch Sicherheit, Performance und Funktionalität prüfen, konzentriert sich die Evaluierung darauf, wie gut die Ausgaben und Entscheidungen tatsächlich sind.
QAwerks LLM-Evaluierungsdienstleistungen kombinieren realistische Datensätze, automatisierte Bewertung und menschliches Urteilsvermögen, um Fehler aufzudecken, die gewöhnliche Testskripte übersehen. Sie erhalten eine klare Qualitäts-Baseline, priorisierte Probleme und Belege für Ihr nächstes Release oder Ihre nächste Modellentscheidung.
Wo Annahmen auf die Realität treffen
Ihr Ergebnis
Weniger Rätselraten, eine klare Qualitäts-Baseline und wiederholbare Prüfungen für jedes Release.Unsere LLM-Evaluierungsdienstleistungen
Evaluierungsstrategie & Metrikdesign
Was bedeutet eine gute Antwort für Ihr Produkt? Wir übersetzen Geschäftsziele in messbare Kriterien, Bewertungsraster, Akzeptanzschwellen und realistische Testszenarien. Ihr Team weiß genau, was zu messen ist und wann die Qualität gut genug für den Release ist.
Golden-Dataset-Erstellung
Wir bauen den Testdatensatz, auf dem Ihre Evaluierungen stehen: reale Nutzerszenarien, Randfälle und adversarielle Eingaben, jeweils mit erwartetem Verhalten und Schweregrad-Labels. Der Datensatz wird versioniert und geschützt, sodass jedes künftige Release an derselben Messlatte gemessen wird.
Evaluierung von Ausgabequalität & Halluzinationen
Wir bewerten jede Antwort nach Genauigkeit, Relevanz, Quellentreue, Befolgen von Anweisungen und Format. So erfahren Sie Ihre echte Halluzinationsrate, welche Szenarien sie auslösen und wie schwer die Fehler wiegen, statt nur einen Durchschnitt, der die gefährlichen verbirgt.
Evaluierung von KI-Agenten & Chatbots
Wir bewerten Aufgabenerfüllung, Genauigkeit der Tool-Aufrufe, Gesprächskonsistenz und mehrstufige Ausführung. Von falschen API-Argumenten bis zu vergessenen Nutzeranweisungen decken wir Fehler auf, die autonome Workflows gefährden. Entdecken Sie unsere spezialisierten Fähigkeiten im Testing von KI-Agenten.
Einrichtung von LLM-als-Richter
Automatisierte Bewertung ist nur nützlich, wenn die Werte etwas bedeuten. Wir entwerfen LLM-als-Richter-Bewertungsraster, vergleichen automatisierte Bewertungen mit menschlichen Einschätzungen und passen die Evaluierungskriterien an, um Bewertungsverzerrungen und unzuverlässige Ergebnisse zu reduzieren.
LLM-Benchmarking-Dienstleistungen & Modellvergleich
Unsere LLM-Benchmarking-Dienstleistungen vergleichen Kandidatenmodelle anhand Ihrer tatsächlichen Aufgaben, nicht nur anhand öffentlicher Ranglisten. Wir messen Qualität, Antwortzeit und Inferenzkosten, damit Sie Modelle mit weniger Überraschungen auswählen, ersetzen oder aktualisieren können.
RAG-Evaluierung
Wir messen Retrieval-Relevanz, Kontextabdeckung, Antworttreue und Zitiergenauigkeit, um zu erkennen, wo wissensbasierte Antworten versagen. Für eine tiefere Validierung der Pipeline entdecken Sie unsere RAG-Testing-Expertise.
Regressions-Evaluierung & CI
Ein Prompt-Update sollte kein Feature zerstören, das gestern noch funktionierte. Wir erstellen wiederholbare Evaluierungssuiten und verbinden sie mit Ihrer Release-Pipeline, damit Ihr Team Qualitätseinbrüche vor dem Deployment erkennt.
Prüfung durch menschliche Experten
Manche Antworten erfordern mehr als einen automatisierten Wert. Wir organisieren strukturierte menschliche Prüfungen mit klaren Bewertungsrastern, binden bei Bedarf Fachspezialisten ein und messen die Übereinstimmung der Prüfer, um nuancierte oder risikoreiche Ausgaben zu validieren.
Ausgewählte Fälle

Granola

Sitch
Brauchen Sie LLM-Evaluierungsdienstleistungen vor Ihrem nächsten Release?
Sprechen wir darüberEinsatzfälle für KI-Modell-Evaluierung
Der Schritt in die Produktion
Ihre Demo hat alle beeindruckt, aber niemand kann sagen, wie sie bei Tausenden echter Fragen abschneidet. Evaluierung gibt Ihnen eine Launch-Schwelle und den Nachweis, dass Sie sie erreicht haben.
Ungemessene Halluzinationen
Nutzer melden erfundene Antworten, aber Sie wissen nicht, ob es 1 von 10 oder 1 von 1.000 ist. Wir messen die Rate und zeigen, wo sie auftritt.
Modellwechsel
Ein neues Modell ist günstiger, oder ein Anbieter-Update hat das Verhalten tatsächlich verändert. Ein direkter Vergleich anhand Ihrer Aufgaben zeigt, was Sie gewinnen und was kaputtgeht.
Prompts ändern
Jede Anpassung behebt einen Fall und bricht still einen anderen. Eine Baseline und eine Regressionssuite zeigen den Nettoeffekt, bevor Sie mergen.
Unzuverlässige KI-Agenten
„Meistens“ reicht nicht, wenn Ihr Agent Rückerstattungen auslöst oder Datensätze bearbeitet. Wir messen, wie zuverlässig er bei wiederholten Durchläufen erfolgreich ist, nicht nur, ob er es kann.
Käufer wollen Belege
Sicherheitsprüfungen großer Unternehmen und KI-Regulierungen fragen inzwischen, wie Sie Ihre KI testen. Wir liefern Ihnen bewertete, reproduzierbare Ergebnisse, die Sie mit Zuversicht teilen können.
Ihr Gewinn mit unseren KI-Evaluierungsdienstleistungen

Mit einer Zahl starten, nicht mit einem Bauchgefühl
Eine klare Qualitäts-Baseline und Bestehensschwelle für den Go-live.

Stille Regressionen abfangen
Jede Prompt- oder Modelländerung wird bewertet, bevor sie live geht.

Modelle auf Basis von Belegen wählen
Vergleichen Sie Qualität, Geschwindigkeit und Kosten an Ihren echten Aufgaben.

Ihren automatisierten Bewertungen vertrauen
Richter, die an menschlichen Experten kalibriert sind, nicht blind übernommen.

Die Nachweisfrage beantworten
Reproduzierbare Ergebnisse für Unternehmenskunden, Prüfer und Ihren Vorstand.

Alles behalten, was wir bauen
Datensätze, Bewertungsraster und Evaluierungssuite liegen in Ihrem Repository.
Darum ist QAwerk die richtige Wahl für LLM-Evaluierung
Unabhängige Perspektive
Viele KI-Evaluierungsdienstleistungen werden von den Teams durchgeführt, die die Modelle bauen oder verkaufen. Wir haben Ihre KI nicht gebaut und haben keinen Anteil an Ihrer Modellwahl, also gibt es keinen Grund, großzügig zu bewerten. Sie erhalten ein unabhängiges Ergebnis, dem Käufer und Investoren vertrauen.
Erfahrung mit echten KI-Produkten
Wir haben LLM-generierte Meeting-Zusammenfassungen für Granola, heute ein Unternehmen im Wert von 1,5 Mrd. USD, mit KI-gestützten Prüfungen in der CI evaluiert. Für Sitch haben wir die Gesprächslogik einer KI-Partnervermittlung validiert, während sie auf 20.000 Vermittlungen pro Tag skalierte. Wir wissen, was kaputtgeht, wenn echte Nutzer kommen.
QA-Disziplin seit 2015
Evaluierung ist im Kern Testing: klare Kriterien, repräsentative Fälle, reproduzierbare Durchläufe. Wir wenden diese Disziplin seit 2015 auf über 250 Projekte an. Unsere KI-Modell-Evaluierungsdienstleistungen bringen sie in die KI, wo lockeres Testdesign Werte erzeugt, die präzise aussehen, aber wenig bedeuten.
Mensch plus Automatisierung
Code-Prüfungen fangen Format- und Logikfehler günstig ab, kalibrierte LLM-Richter decken Bedeutung im großen Maßstab ab, und Human-in-the-Loop-Prüfung übernimmt nuancierte Fälle. Wir wählen die Mischung pro Metrik, damit Sie bei einfachen Prüfungen nicht zu viel zahlen und Ermessensentscheidungen nicht dem Code überlassen.
Erfahren, ausgezeichnet und sicher
Wir haben über 30 erfahrene QA-Ingenieure, einen Platz in der Global Outsourcing 100 der IAOP und Kunden, die Branchenpreise gewinnen und von Marktführern übernommen werden. Wir betreuen Teams in den USA, Australien, Neuseeland und Westeuropa, unterzeichnen NDAs und halten Ihre Prompts und Daten in Umgebungen, die Sie freigeben.
Produktspezifische Evaluierung
Unsere LLM-Modell-Evaluierungsdienstleistungen zwingen nicht jeden Kunden in einen einzigen Benchmark oder eine einzige Plattform. Ein RAG-Assistent, ein Kundensupport-Chatbot und ein autonomer Agent brauchen unterschiedliche Datensätze, Metriken und Evaluierungs-Workflows. Wir passen den Umfang an die Risiken, die technische Umgebung und die Geschäftsziele Ihres Produkts an, einschließlich vereinbarter Anforderungen an den Umgang mit Daten.
QAwerk unterstützt uns kontinuierlich beim Testen sowohl unserer Desktop- als auch unserer mobilen Apps. Das Team führt automatisierte und manuelle Tests aller Funktionen durch, die von der Installation über die Benutzererfahrung bis hin zu KI-generierten Antworten reichen. Es ist dem Team gelungen, schwerwiegende Fehler zu entdecken, bevor diese veröffentlicht wurden, und hat uns so vor einer Katastrophe bewahrt! Außerdem konnten wir im Allgemeinen weiterhin schnell neue Versionen veröffentlichen und wurden nicht durch unsere begrenzten Testkapazitäten ausgebremst. Sie sind stets pünktlich, zuverlässig, reaktionsschnell und gehen flexibel auf unsere Bedürfnisse ein, die sich oft in letzter Minute ändern. Ihre Kommunikation und ihre Liebe zum Detail bei der Fehlermeldung sind beeindruckend. Man hat das Gefühl, dass sie sowohl im übertragenen als auch im wörtlichen Sinne Teil unseres Teams sind! Sehr zu empfehlen!

QAwerk führt für uns Tests unserer Cloud-Plattform durch. Außerdem haben sie uns dabei geholfen, Bilder und Videos für Machine-Learning-Zwecke zu annotieren. Mir gefällt die Herangehensweise von QAwerk: Letztendlich sind es wieder einmal gute Leute, die interessiert und motiviert sind, Dinge zu tun, und manchmal sogar mehr erreichen, als wir erwarten.
Weitere Dienstleistungen, die wir anbieten
KI-Testing
Wir testen KI-gestützte Produkte durchgängig: Funktionalität, Integrationen, Datenverarbeitung und Nutzererlebnis. Es ist das Sicherheitsnetz rund um Ihre LLM-Evaluierungen, damit ein starkes Modell nicht durch die App darum herum ausgebremst wird.

Penetrationstesting
Prompt Injection und Datenabfluss sind Sicherheitsprobleme, keine Qualitätswerte. Unsere Pentester prüfen Ihre App, APIs und KI-Funktionen so, wie es echte Angreifer tun würden, und zeigen Ihnen, wie Sie jede Lücke schließen.
API-Testing
Wir verifizieren, wie Ihre KI sich in externe Tools, CRMs, Suchdienste und Geschäftssysteme integriert, einschließlich Fehlerantworten, Zugriffsberechtigungen und Datenkonsistenz über Workflows hinweg.
Lokalisierungstesting
Wir prüfen, ob Ihre KI-gestützte App über Sprachen, Dialekte, regionale Formate und kulturelle Erwartungen hinweg konsistent funktioniert, insbesondere wenn die Antwortqualität zwischen Märkten und Nutzergruppen schwankt.
Compliance-Testing
Regulierungsbehörden und Unternehmenskunden fragen zunehmend, wie Ihre KI getestet wird. Wir ordnen Pflichten Testfällen zu und liefern Nachweispakete, die Evaluierungsergebnisse in prüfungsfähige Belege verwandeln.
Automatisiertes Testing
Wir bauen Automatisierungs-Frameworks, die bei jedem Build in Ihrer CI laufen. Zusammen mit Evaluierungssuiten fangen sie defekte Abläufe und Qualitätseinbrüche ab, bevor ein Release Ihre Nutzer erreicht.
Tools, die wir einsetzen
FAQ
Was ist LLM-Evaluierung?
LLM-Evaluierung ist der Prozess, zu messen, wie gut ein Large Language Model oder die darauf aufbauende App ihre vorgesehene Aufgabe erfüllt. Sie bewertet Ausgaben anhand von LLM-Evaluierungsmetriken wie Genauigkeit, Relevanz, Quellentreue, Sicherheit und Aufgabenerfüllung, mithilfe eines Testsatzes, der die reale Nutzung widerspiegelt. Das Ergebnis ist eine Baseline, die Sie über Prompts, Modelle und Releases hinweg vergleichen können.
Worin unterscheidet sich LLM-Evaluierung von LLM-Testing?
LLM-Testing prüft, ob das System funktioniert: Features laufen, Antworten kommen schnell, Integrationen halten, und Angreifer können es nicht aushebeln. LLM-Evaluierung misst die Qualität dessen, was das Modell sagt und tut, meist als Werte gegen Schwellenwerte statt als einfache Bestanden-oder-nicht-Prüfungen. Die meisten produktiven KI-Systeme brauchen beides.
Welche Metriken verwenden Sie zur Evaluierung von LLMs?
Das hängt von Ihrem Anwendungsfall ab. Für generierte Antworten messen wir typischerweise Korrektheit, Relevanz, Faktentreue, Halluzinationsrate und das Befolgen von Anweisungen. RAG-Apps kommen mit Kontextpräzision und Kontextvollständigkeit hinzu; Agenten mit Aufgabenerfüllung, Genauigkeit der Tool-Aufrufe und Zuverlässigkeit über wiederholte Durchläufe. Wir verfolgen außerdem Sicherheit, Latenz und Kosten pro erfolgreicher Aufgabe, wenn sie Ihre Release-Entscheidung beeinflussen.
Wie evaluieren Sie KI-Agenten und Chatbots?
Wir betrachten den gesamten Weg, nicht nur die endgültige Antwort. Bei Agenten verwenden wir Evaluierungsmetriken für KI-Agenten, um zu prüfen, ob die Aufgabe abgeschlossen wurde, ob die richtigen Tools mit den richtigen Argumenten aufgerufen wurden, wie viele Schritte verschwendet wurden und wie sich der Agent von Fehlern erholt. Bei Chatbots führen wir mehrstufige Szenarien aus, um Konsistenz, Kontexterhalt und Tonalität zu testen. Wir wiederholen jeden Durchlauf, um zu sehen, wie zuverlässig das System erfolgreich ist.
Was ist LLM-als-Richter, und kann man ihm vertrauen?
LLM-als-Richter bedeutet, ein Modell zu verwenden, um die Ausgaben eines anderen Modells anhand eines Bewertungsrasters zu bewerten. Das macht die Evaluierung schnell und skalierbar, aber Richter haben bekannte Verzerrungen: Sie bevorzugen längere Antworten, die zuerst gezeigte Option und Texte, die wie ihre eigenen klingen. Einem Richter kann man vertrauen, sobald er kalibriert ist. Wir vergleichen seine Bewertungen mit menschlichen Labels und verfeinern ihn, bis er mit Expertenprüfern auf Ihren Daten übereinstimmt.
Brauchen wir eine Evaluierungsplattform oder einen Service?
Eine Plattform wie LangSmith oder DeepEval liefert die Infrastruktur, um Evaluierungen auszuführen. Sie entscheidet nicht, was zu messen ist, baut keine Testdaten und prüft nicht, ob Ihre Richter richtig liegen. Ein Service leistet diese Designarbeit. Wir richten die Tools in Ihrem Stack ein und betreiben sie, sodass Sie Ergebnisse und eine funktionierende Evaluierungssuite erhalten statt eines weiteren Tools, das Sie erlernen müssen.
Lässt sich LLM-Evaluierung automatisieren?
Weitgehend ja. Sobald Metriken, Datensätze und Richter stehen, können Evaluierungen als automatisiertes LLM-Regressionstesting in der CI bei jeder Prompt-, Modell- oder Retrieval-Änderung laufen. Menschliche Prüfung bleibt wichtig, um Ground Truth aufzubauen, Richter zu kalibrieren und folgenreiche oder mehrdeutige Fälle zu prüfen. Ein gutes Setup automatisiert den Großteil der Bewertung und schickt nur unsichere Ergebnisse an Menschen.
Wie lange dauert eine LLM-Evaluierung?
Eine fokussierte Evaluierung eines einzelnen LLM-Features dauert in der Regel zwei bis vier Wochen, von der Definition der Erfolgskriterien bis zu einem bewerteten Baseline-Bericht. Agentische oder Multi-Modell-Systeme, menschliche Expertenprüfung oder mehrere Sprachen können das auf sechs bis acht Wochen verlängern. Nach einem kurzen Scoping-Gespräch nennen wir Ihnen einen realistischen Zeitplan.
Verwandtes in unserem Blog
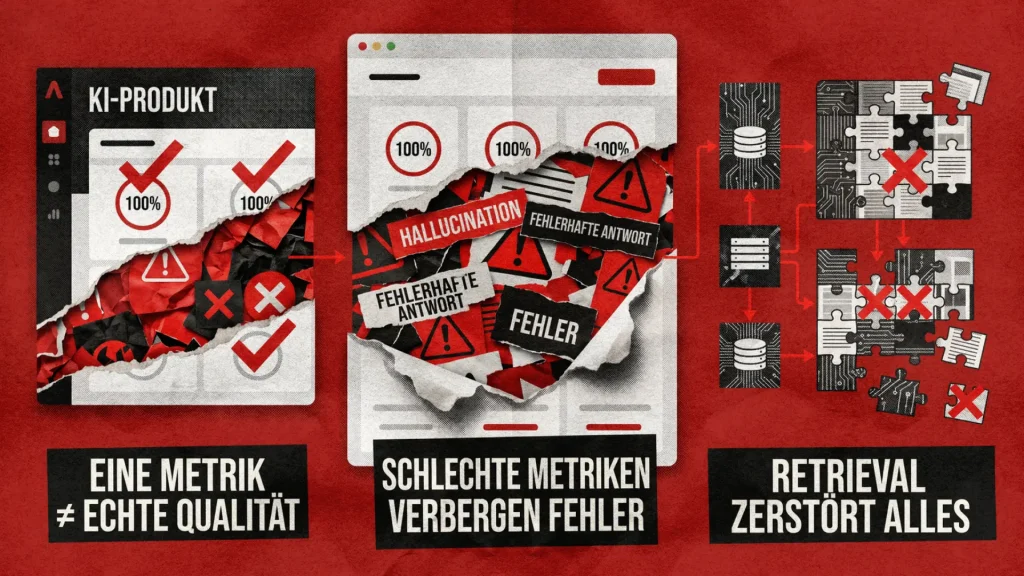
Die 10 wichtigsten Bewertungskriterien für LLM-Studiengänge, die Sie kennen müssen
Die Einführung eines LLM ohne eine geeignete Evaluierungsstrategie ist ein riskantes Unterfangen, dessen Tragweite den meisten Teams nicht bewusst ist. Weltweit setzen 67 % der Unternehmen LLMs produktiv ein, doch die Mehrheit verlässt sich weiterhin auf Evaluierungsmetriken, d...
Mehr lesen
Was ist EvalOps? Die Praxis, die jedes KI-Produktteam vor dem Launch braucht
Stellen Sie sich vor, Sie liefern ein KI-Produkt aus, das jede Demo perfekt meistert. Ihr Team testet es vor dem Launch gründlich, und die Ausgaben sehen scharf aus, also liefern Sie mit Zuversicht. Jedoch schickt Ihnen zwei Wochen später ein Kunde einen Screenshot einer Antwor...
Mehr lesen
Wie wir Chatbots bewerten, die unterschiedliche Antworten auf dieselbe Frage geben
Wenn Ihr QA-Chatbot drei unterschiedliche Antworten auf dieselbe Frage gibt, verlieren die Nutzer das Vertrauen, lange bevor Ihr Funnel-Bericht dies nachholt....
Mehr lesen
8 RAG-Bewertungsinstrumente zum Testen und Debuggen von LLM-Anwendungen
Die meisten Fehler bei RAG-Systemen scheinen auf den ersten Blick keine zu sein. Das Modell wirkt zuverlässig. Die Antwort liest sich korrekt. Doch der abgerufene Kontext war falsch, oder die Antwort wich völlig vom Original ab....
Mehr lesenFinden Sie heraus, wie gut Ihr LLM wirklich ist
Sie wissen nicht, wie man ein LLM evaluiert, das Ihrem ähnelt? Erzählen Sie uns, was Ihre KI tut, und wir schlagen vor, was zuerst zu messen ist, und sagen Ihnen ehrlich, ob wir der richtige Partner sind.
11+
JAHRE IN REGULIERTEN BEREICHEN300+
GETESTETE PROJEKTE30%
NIEDRIGERE LLM-KOSTEN2–4
WOCHEN BIS ZUR QUALITÄTS-BASELINE